
2006年下半年全国自考(数据结构)真题试卷
一、1.单项选择题
0. 数据结构是 ( )
A.一种数据类型
B.数据的存储结构
C.一组性质相同的数据元素的集合
D.相互之间存在一种或多种特定关系的数据元素的集合
1. 算法分析的目的是 ( )
A.辨别数据结构的合理性
B.评价算法的效率
C.研究算法中输入与输出的关系
D.鉴别算法的可读性
2. 性表的下列运算中,不改变数据元素之间结构关系的运算是 ( )
A.插入
B.删除
C.排序
D.定位
3. 若进栈序列为1,2,3,4,5,6,且进栈和出栈可以穿插进行,则可能出现的出栈序列为( )
A.3,2,6,1,4,5
B.3,4,2,1,6,5
C.1,2,5,3,4,6
D.5,6,4,2,3,1
4. 设串s1="Data Structures、with Java",s2="it",则子串定位函数index(s1,s2)的值为 ( )
A.15
B.16
C.17
D.18
5. 二维数组A[8][9]按行优先顺序存储,若数组元素A[2][3]的存储地址为1087,A[4][7]的存储地址为1153,则数组元素A[6][7]的存储地址为 ( )
A.1207
B.1209
C.1211
D.1213
6. 在按层次遍历二叉树的算法中,需要借助的辅助数据结构是 ( )
A.队列
B.栈
C.线性表
D.有序表
7. 在任意一棵二叉树的前序序列和后序序列中,各叶子之间的相对次序关系 ( )
A.不一定相同
B.都相同
C.都不相同
D.互为逆序
8. 若采用孩子兄弟链表作为树的存储结构,则树的后序遍历应采用二叉树的 ( )
A.层次遍历算法
B.前序遍历算法
C.中序遍历算法
D.后序遍历算法
9. 若用邻接矩阵表示一个有向图,则其中每一列包含的"1"的个数为 ( )
A.图中每个顶点的入度
B.图中每个顶点的出度
C.图中弧的条数
D.图中连通分量的数目
10. 图的邻接矩阵表示法适用于表示 ( )
A.无向图
B.有向图
C.稠密图
D.稀疏图
11. 在对n个关键字进行直接选择排序的过程中,每一趟都要从无序区选出最小关键字元素,则在进行第i趟排序之前,无序区中关键字元素的个数为 ( )
A.i
B.i+1
C.n-i
D.n-i+1
12. 下列排序算法中,其时间复杂度和记录的初始排列无关的是 ( )
A.插入排序
B.堆排序
C.快速排序
D.冒泡排序
13. 若有序表的关键字序列为(b,c,d,e,f,g,q,r,s,t),则在二分查找关键字b的过程中,先后进行比较的关键字依次为 ( )
A.f,c,b
B.f,d,b
C.g,c,b
D.g,d,b
14. 若在文件中查询年龄在60岁以上的男性及年龄在55岁以上的女性的所有记录,则查询条件为 ( )
A.(性别="男")OR(年龄>60)OR(性别="女")OR(年龄>55)
B.(性别="男")OR(年龄>60)AND(性别="女")OR(年龄>55)
C.(性别="男")AND(年龄>60)OR(性别="女")AND(年龄>55)
D.(性别="男")AND(年龄>60)AND(性别="女")AND(年龄>55)
二、2.填空题
0. 称算法的时间复杂度为O(f(n)),其含义是指算法的执行时间和______的数量级相同。
1. 在一个长度为n的单链表L中,删除链表中*p的前驱结点的时间复杂度为______。
2. 假设为循环队列分配的向量空间为Q[20],若队列的长度和队头指针值分别为13和17,则当前尾指针的值为______。
3. 设s="I AM A ATHLETE",t="GOOD",则执行下列串操作序列之后得到的suhl为______。
substr(sub1,s,5,2);substr(sub2,s,6,8);strcpy(t1,t);
strcat,(t1,sub2);strcat(sub1,t1);
4. 广义表的深度是指______。
5. 一棵含999个结点的完全二叉树的深度为______。
6. 含n个顶点的无向连通图中至少含有______条边。
7. 对表长为9000的索引顺序表进行分块查找,假设每一块的长度均为15,且以顺序查找确定块,则在各记录的查找概率均相等的情况下,其查找成功的平均查找长度为______。
8. 若对关键字序列(43,02,80,48,26,57,15,73,21,24,66)进行一趟增量为3的希尔排序,则得到的结果为______。
9. ISAM文件由主索引、______、______和主文件组成。
三、3.解答题
0. 某广义表的表头和表尾均为(a,(b,c)),画出该广义表的图形表示。
1. 已知二叉树的先序序列和中序序列分别为HDACBGFE和ADCBHFEG。
(1)画出该二叉树;
(2)画出与(1)求得的二叉树对应的森林。
2. 已知带权图的邻接表如下所示,其中边表结点的结构为: 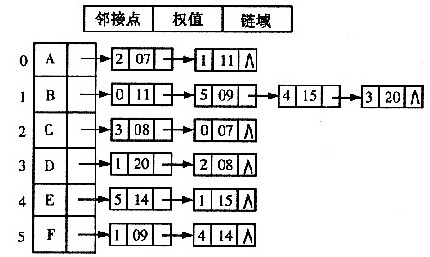
依此邻接表从顶点C出发进行深度优先遍历。
(1)画出由此得到的深度优先生成树;
(2)写出遍历过程中得到的从顶点C到其他各顶点的带权路径及其长度。
3. 从空树起,依次插入关键字37,50,42,18,48,12,56,30,23,构造一棵二叉排序树。
(1)画出该二叉排序树;
(2)画出从(1)所得树中删除关键字为37的结点之后的二叉排序树。
四、4.算法阅读题
0. 已知用有序链表存储整数集合的元素。阅读算法。f30,并回答下列问题:
(1)写出执行f30(a,b)的返回值,其中a和b分别为指向存储集合{2,4,5,7,9,12}和{2,4,5,7,9}的链表的头指针;
(2)简述算法f30的功能;
(3)写出算法f30的时间复杂度。
int f30(LinkList ha,LinkList hb)
{
//LinkList是带有头结点的单链表
//ha和hb分别为指向存储两个有序整数集合的链表的头指针
LinkList pa,pb;
pa=ha—>next;
pb=hb—>next;
while(pa&&pb&&pa—>data==pb—>data)
{ pa=pa—>next;
pb=pb—>next;
}
if(pa==NULL&&pb==NULL)return 1;
else return 0;
}
1. 已知稀疏矩阵采用带行表的三元组表表示,其形式说明如下:
#define MaxRow 100 //稀疏矩阵的最大行数
typedef struct{
int i,j,v; //行号、列号、元素值
}TriTupleNode;
typedef struct{
TriTupleNode data[MaxSize];
int RowTab[MaxRow+1]; //行表
int m,n,t; //矩阵的行数、列数和非零元个数
}RTriTupleTable; 下列算法f31的功能是,以行优先的顺序输入稀疏矩阵的非零元(行号、列号、元素值),建立稀疏矩阵的带行表的三元组表存储结构。请在空缺处填入合适内容,使其成为一个完整的算法。(注:矩阵的行、列下标均从1起计)
void f31(RTriTupleTable*R)
{ int i,k;
scanf("%d%d%d",&R—>m,&R—>n,&LR—>t);
R—>RowTab[1]=0;
k=1; //k指示当前输入的非零元的行号
for(i=0;[ ① ];i++)
{ scanf("%d%d%d",[ ② ],[ ③ ],&R—>data[i].v);
while(k<R->data[i].i)
{[ ④ ];
R—>RowTab[k]=i;
}
}
}
2. 已知二叉树的存储结构为二叉链表,其类型定义如下:
typedef struct NodeType{
DataType data;
struct NodeType*lchild,*rchild;
}BinTNode,*BinTree;
阅读算法f32,并回答下列问题:
(1)对于如图所示的二叉树,画出执行算法f32的结果;
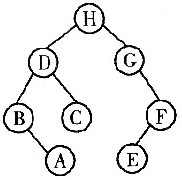
(2)简述算法f32的功能。
BinTree f32(BinTree bt1)
{
BinTree bt2;
if(bt1==NULL)
bt2=NULL;
else{
bt2=(BinTNode*)malloc(sizeof(BinTNode));
bt2—>data=bt1—>data;
bt2—>rchild=f32(bt1—>lchild);
bt2—>lchild=f32(bt1—>rchild);
}
return bt2;
}
4.假设有向图采用邻接表表示法,其定义如下:
typedef struct{
VertexNode adjlist[MaxVertexNum];
int n,e; //图的当前顶点数和弧数
}ALGraph //邻接表类型
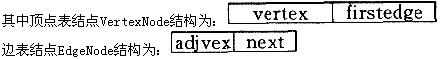
下列算法f33的功能是,对以邻接表表示的有向图进行拓扑排序。
(1)阅读算法f33,并在空缺处填入合适的内容,使其成为一个完整的算法;
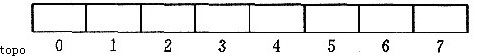
(2)对于如图所示的邻接表,将执行算法f33后的topo[]结果填入给定的数组中。
void f33(ALGraph G,int topo []){
int i,j,k,count=0;
int indegree[MaxVertexNum];
EdgeNode*p;//p为指向边表结点的指针
Queue Q;//Q为队列
FindIndegree(G,indegree);//求各顶点的入
度,并置于入度向量indegree
InitQueue(&Q);
for(i=0;i<G.n;i++)
if(!indegree[i])EnQueue(&Q,i);
while(!QueueEmpty(&Q)){
j=[ ① ];
topo[j]=++count
for(p=G.adjlist[j].firstedge;p;p=p—>next){
k=p—>adjvex;
if(!(--indegree[k]))[ ② ];
}
}
if(count<G.n)printf("
图G中存在有环路");
}
①
②
5.
五、5.算法设计题
0. 假设以带头结点的单链表表示有序表,单链表的类型定义如下:
typedef struct node{
DataType data;
struct node*next
}LinkNode,*LinkList;
编写算法,从有序表A中删除所有和有序表B中元素相同的结点。


